

Cada semana aparece un nuevo modelo dispuesto a ser el más inteligente, el más rápido o el que viene a dejar obsoletos a todos los anteriores. El problema ya no es encontrar una inteligencia artificial, sino decidir cuál utilizar y, sobre todo, en qué datos confiar para hacerlo. Hay rankings para casi todo, aunque no todos miden lo mismo. Estas seis webs permiten observar la carrera de la IA con algo más de criterio y bastante menos ruido.
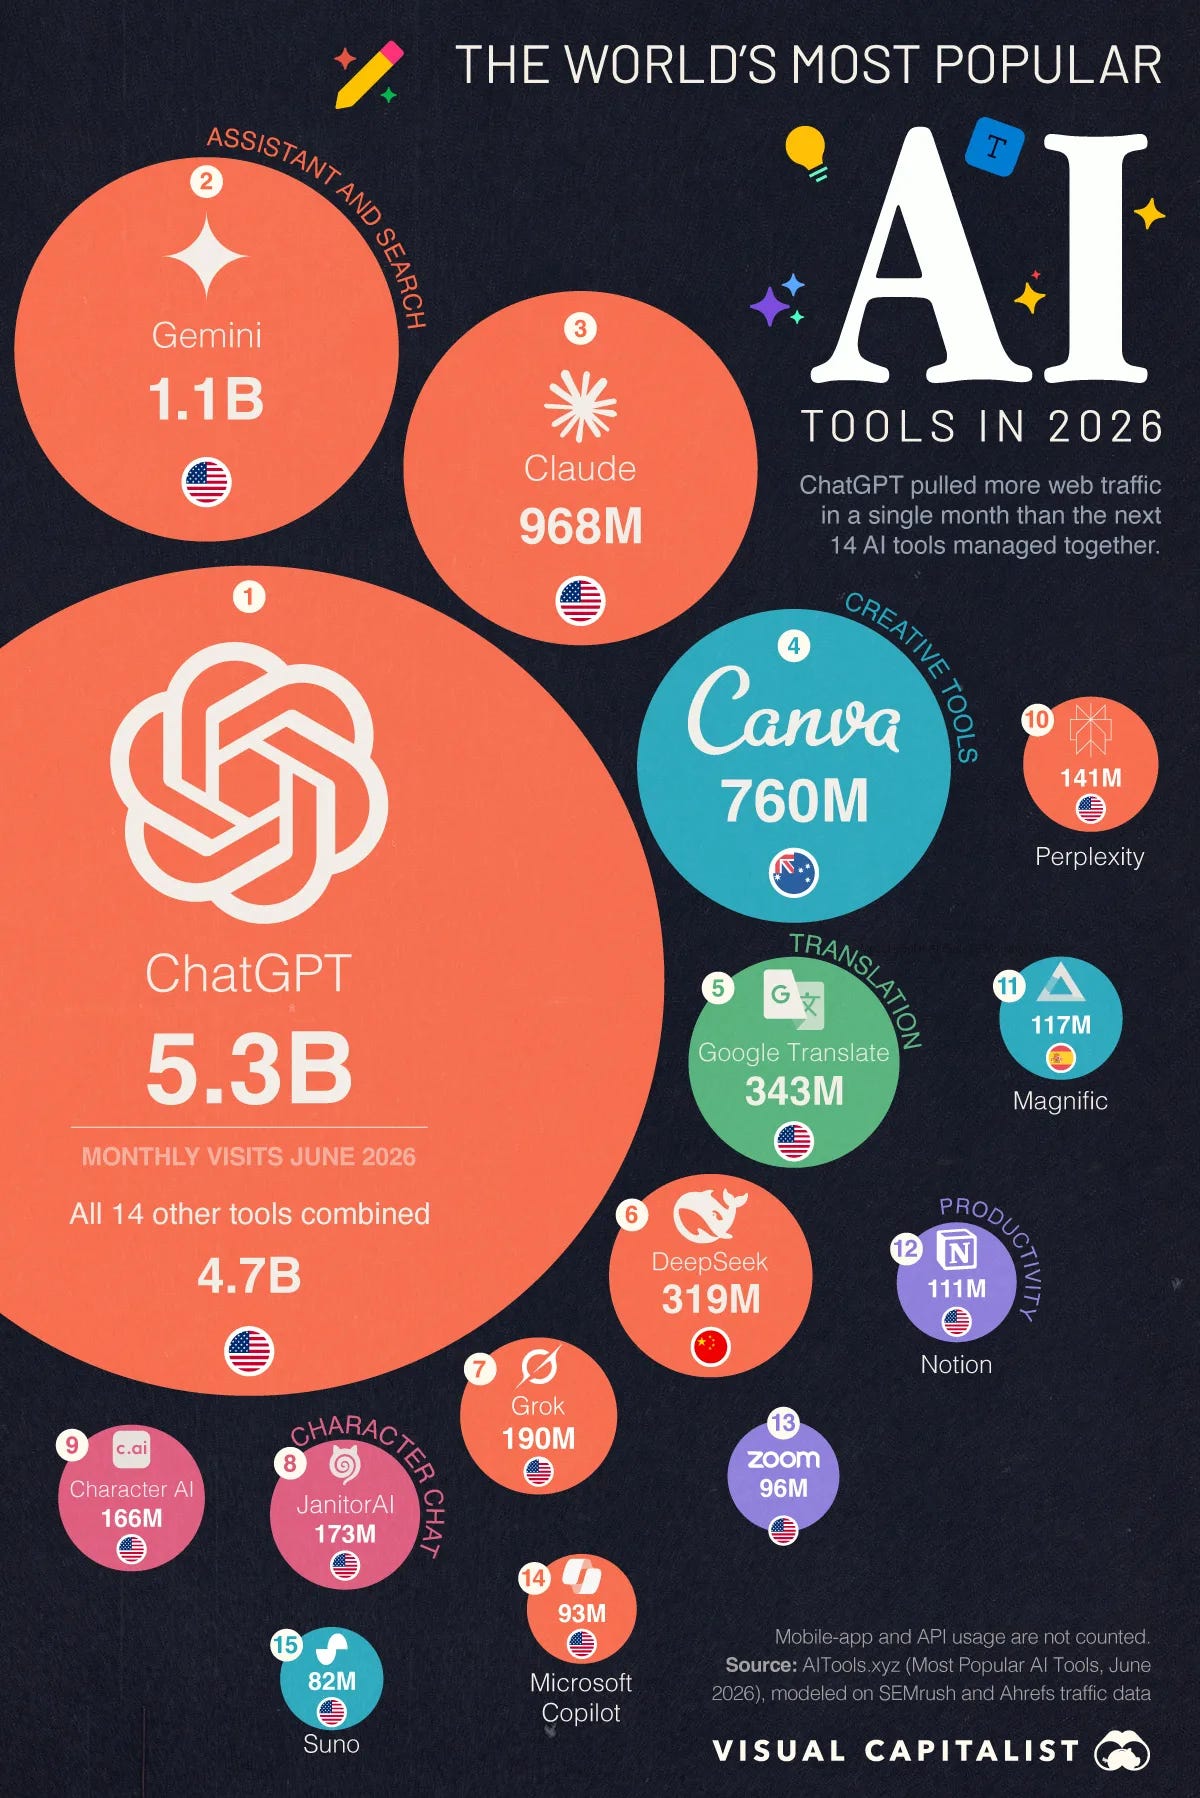
Hay gráficos que parecen cerrar una discusión antes de empezarla. Hace poco encontré uno de Visual Capitalist sobre las herramientas de inteligencia artificial más populares del mundo. La imagen es difícil de ignorar: un enorme círculo representa a ChatGPT y alrededor aparecen Gemini, Claude, Canva, DeepSeek, Grok, Perplexity, Copilot y otros nombres cada vez más familiares.
La lectura rápida es sencilla: ChatGPT domina. Pero conviene fijarse en qué se está midiendo. La infografía habla de tráfico web, no de calidad, ni de coste, ni de precisión, ni siquiera de todo el uso real que hacemos de esas herramientas. Una persona puede utilizar Copilot dentro de Word, un programador puede consumir millones de tokens desde una API y alguien puede trabajar con una aplicación móvil sin visitar nunca la página web del modelo.
La popularidad importa, claro. Dice algo sobre adopción, marca y hábito. Pero no responde a la pregunta que de verdad nos interesa cuando tenemos trabajo delante: ¿qué IA me conviene usar?
Ahí empieza el problema. Hemos convertido “la mejor IA” en una especie de título mundial, cuando en realidad la palabra “mejor” es demasiado grande. ¿Mejor para escribir? ¿Para programar? ¿Para investigar? ¿Para trabajar rápido? ¿Para ahorrar dinero? ¿Para generar imágenes? ¿Para resolver problemas matemáticos? Cada pregunta necesita un criterio distinto.
Este post no va, por tanto, de encontrar más herramientas. Ya tenemos suficientes. Va de aprender a mirar mejor. De saber dónde comprobar qué modelo destaca, cuánto cuesta, cómo responde y qué están usando otras personas cuando el marketing desaparece de la ecuación.
Artificial Analysis: cuando el ranking deja de ser una carrera de caballos
Artificial Analysis:(https://artificialanalysis.ai/) es probablemente el mejor punto de partida para entender que comparar modelos ya no consiste en colocar nombres del uno al diez. Su interfaz puede resultar algo fría al principio: gráficas, tokens por segundo, latencias, precios, ventanas de contexto y puntuaciones. Pero esa aparente complejidad es precisamente su valor.
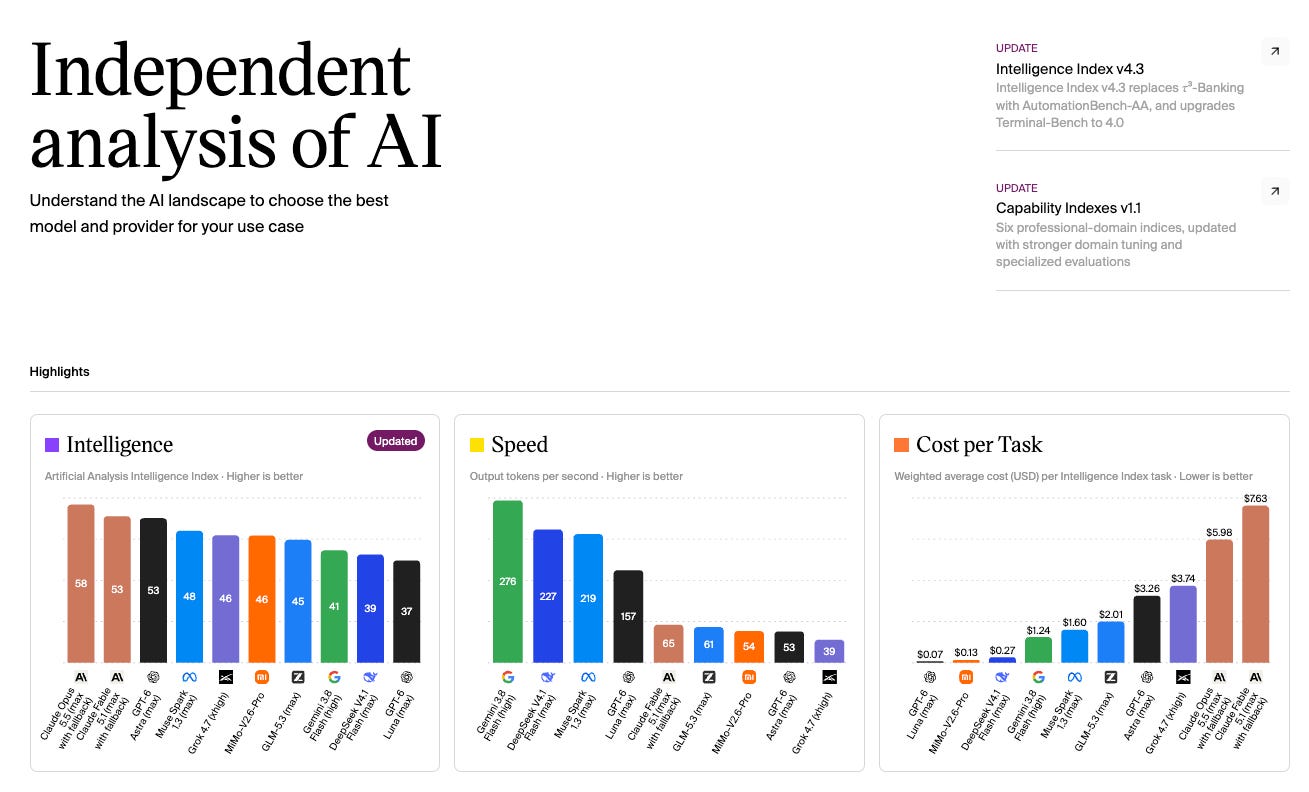
La plataforma permite comparar modelos teniendo en cuenta varias variables a la vez. Un modelo puede ofrecer un rendimiento extraordinario y, sin embargo, ser demasiado caro o lento para determinadas tareas. Otro puede quedar ligeramente por debajo en inteligencia, pero resultar mucho más útil cuando necesitas procesar miles de documentos o ejecutar una operación cientos de veces al día.
Ese matiz cambia la forma de elegir. Si necesitas analizar un contrato delicado, probablemente estés dispuesto a asumir más coste a cambio de mejor razonamiento. Si quieres clasificar automáticamente diez mil comentarios de clientes, quizá prefieras un modelo suficientemente bueno, barato y rápido.
Artificial Analysis también permite mirar más allá de los grandes chatbots. Incluye comparativas relacionadas con imagen, vídeo, voz y programación. El resultado no es un ganador absoluto, sino algo más útil: un mapa en el que cada modelo ocupa una posición diferente según el trabajo que quieras hacer.
La primera lección aparece pronto: elegir IA empieza a parecerse menos a elegir una marca y más a elegir una herramienta profesional.
Arena: quitar la etiqueta y mirar la respuesta
Arena (https://arena.ai/) hace algo aparentemente más sencillo. Presenta dos respuestas generadas por modelos diferentes sin decirte cuáles son. Tú lees, comparas y eliges la que prefieres. Solo después descubres qué había detrás de cada una.
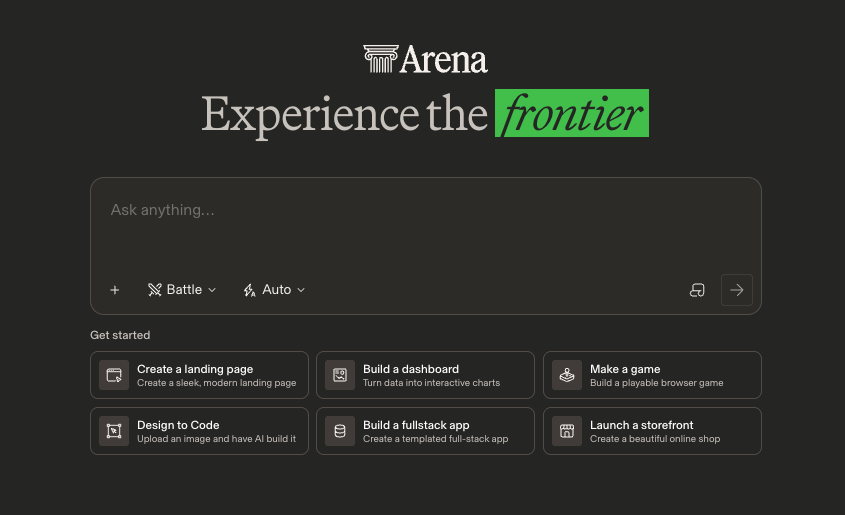
La gracia está en quitar la marca durante unos minutos. Todos llegamos condicionados. Si llevamos años utilizando ChatGPT, miramos sus respuestas de una manera. Si hemos leído que Claude escribe mejor o que Gemini acaba de superar a sus competidores, esa expectativa también pesa. Arena intenta reducir ese efecto y colocar el resultado delante del nombre.
Los votos de los usuarios sirven después para construir rankings basados en preferencias humanas. La plataforma permite comparar modelos en diferentes terrenos, desde texto hasta programación, búsqueda, visión o generación de imágenes.
No es una medida perfecta. Las personas podemos preferir una respuesta porque está mejor redactada, porque parece más segura o porque coincide con nuestra forma de pensar, aunque no sea necesariamente la más exacta. Pero Arena mide algo que los benchmarks tradicionales capturan peor: la experiencia real de trabajar con una respuesta.
Y eso importa. Podemos pasar horas delante de una IA. No basta con que apruebe exámenes. También tiene que ayudarnos a pensar, escribir o resolver problemas sin convertirse en otra fuente de fricción.
OpenRouter Rankings: observar lo que la gente usa cuando tiene que pagar la factura
OpenRouter (https://openrouter.ai/rankings) introduce otra perspectiva: el uso real. Es una infraestructura que permite a desarrolladores acceder a distintos modelos desde un mismo entorno. Eso le permite observar qué modelos están siendo utilizados, cuánto volumen procesan y cómo cambia esa utilización con el tiempo.
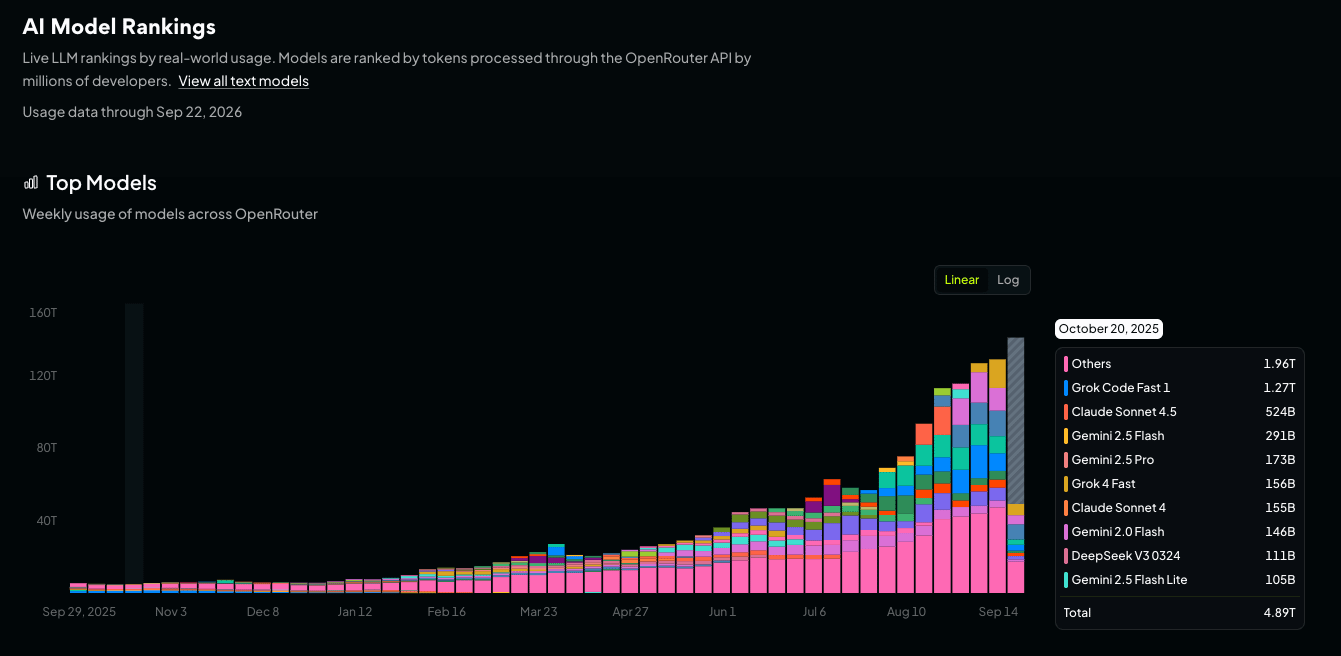
Aquí el interés no está en lo que la gente dice que prefiere, sino en lo que realmente está usando. Sus rankings muestran actividad basada en tokens procesados y permiten explorar tendencias y categorías de uso.
La diferencia es importante. Cuando un desarrollador elige un modelo para poner una aplicación en producción, la decisión suele ser menos emocional. Hay costes, velocidad, estabilidad y rendimiento en juego. Una décima de mejora en un benchmark puede dejar de importar si multiplica la factura mensual.
También permite descubrir modelos que apenas aparecen en las conversaciones generales pero tienen mucha presencia en determinadas tareas. Un modelo puede estar funcionando especialmente bien en programación; otro, en investigación o análisis; otro puede ser atractivo simplemente porque ofrece una relación coste-rendimiento difícil de ignorar.
La limitación es evidente: OpenRouter solo ve lo que ocurre dentro de su propio ecosistema. No representa todo el mercado. Aun así, proporciona una señal valiosa porque observa comportamiento, no declaraciones.
LiveBench: cambiar el examen para que memorizarlo no sirva
Los benchmarks tienen un problema incómodo. Los modelos se entrenan con cantidades enormes de información disponible en Internet y muchas de las pruebas utilizadas para evaluarlos también circulan por Internet. En algunos casos, la frontera entre resolver una prueba y haber visto previamente algo parecido puede volverse borrosa.
LiveBench (https://livebench.ai/) intenta combatir ese problema renovando sus evaluaciones y utilizando tareas que puedan corregirse de forma objetiva. Evalúa áreas como razonamiento, matemáticas, programación, análisis de datos, lenguaje y seguimiento de instrucciones.
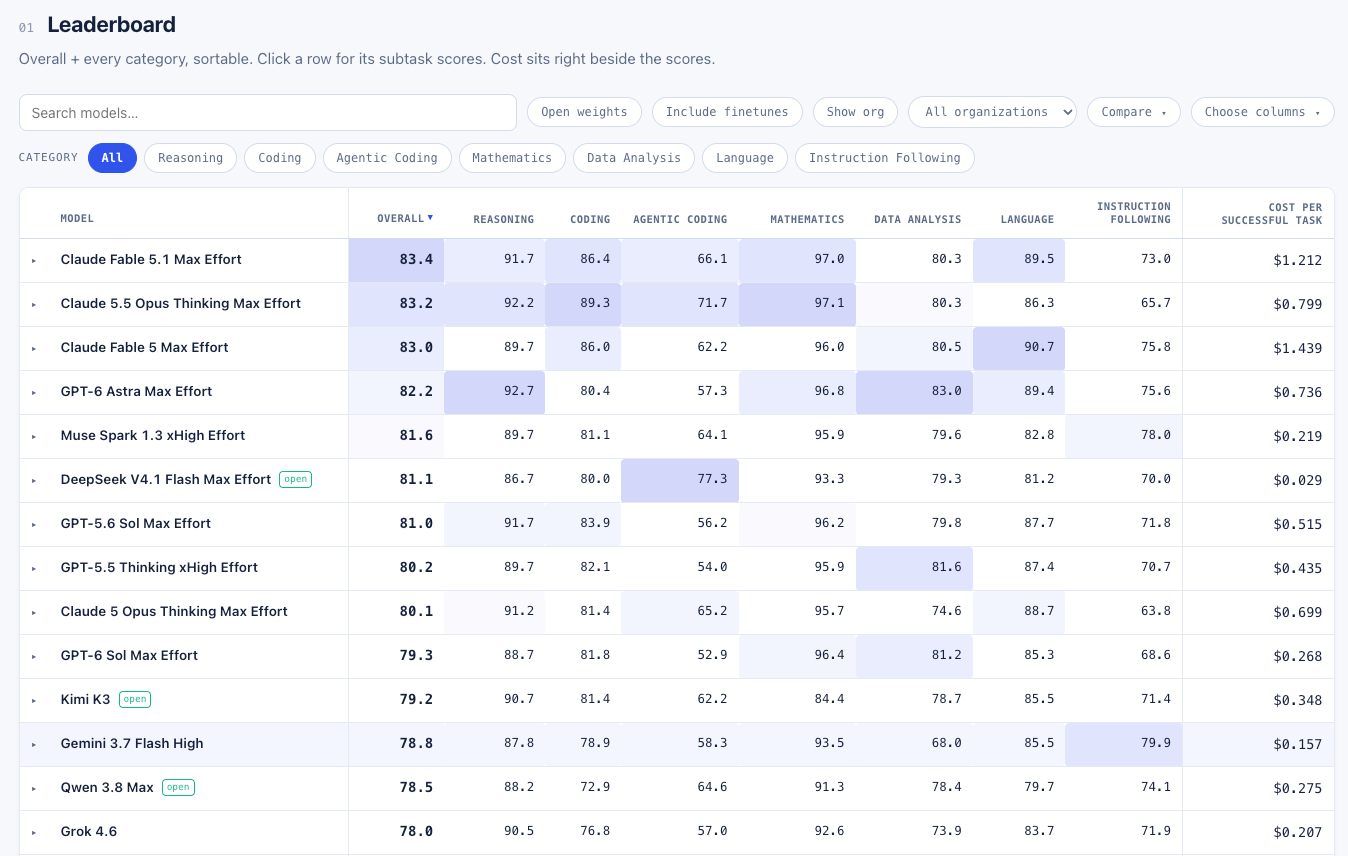
La idea se entiende mejor pensando en un examen. Si un alumno conoce las preguntas antes de entrar en clase, una nota excelente ya no significa exactamente lo mismo. LiveBench intenta cambiar las preguntas con suficiente frecuencia como para que la prueba siga teniendo valor.
Para el usuario corriente quizá no sea la web más cómoda de consultar, pero enseña algo esencial: un ranking no vale demasiado si no sabemos cómo se ha construido.
Cada vez que aparezca un titular diciendo que un modelo ha superado a todos los demás, conviene hacer una pausa. ¿En qué prueba? ¿Qué capacidad estaba midiendo? ¿Cuándo se diseñó? ¿Hasta qué punto esa prueba representa el trabajo que nosotros vamos a realizar?
Los números ayudan. Pero también pueden tranquilizarnos demasiado.
Epoch AI: mirar la película y no solo la foto del día
Epoch AI (https://epoch.ai/benchmarks) resulta especialmente interesante para quienes quieren entender hacia dónde avanza la tecnología, no solo qué modelo ocupa hoy la primera posición. Reúne resultados de numerosos modelos y benchmarks y permite observar cómo evolucionan las capacidades a lo largo del tiempo.
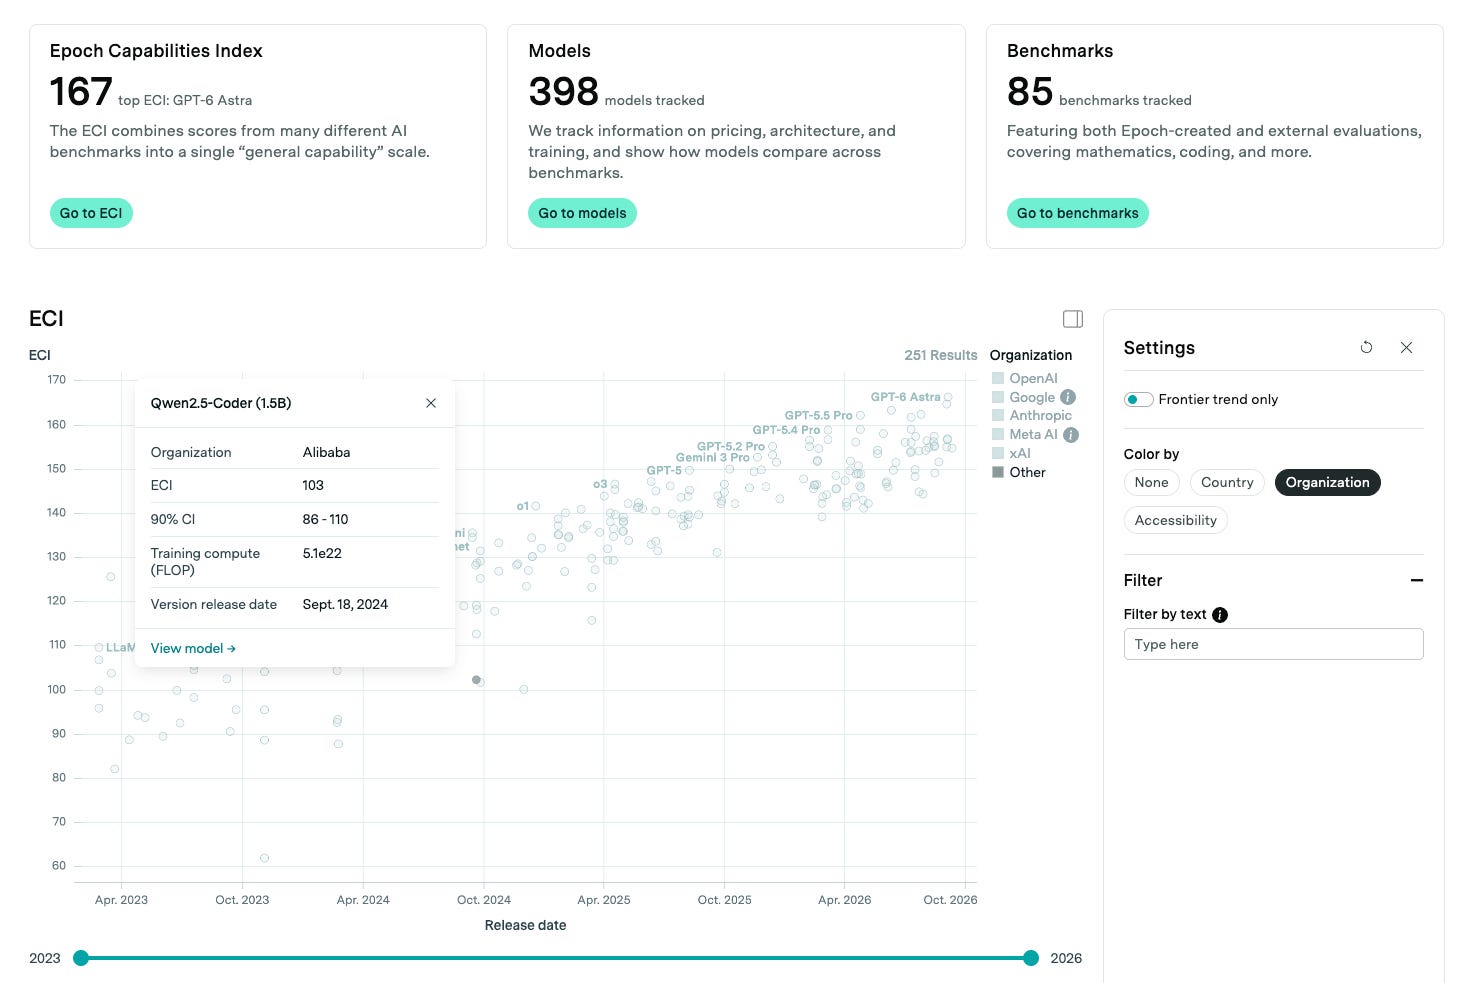
La perspectiva cambia. Dejamos de mirar únicamente el lanzamiento de esta semana y empezamos a observar tendencias más largas: qué problemas eran difíciles hace dos años y ya no lo son, qué capacidades mejoran con rapidez y cuáles siguen resistiéndose.
Es una diferencia importante porque la actualidad de la IA tiene algo agotador. Cada lanzamiento se presenta como una ruptura histórica y, tres meses después, ya estamos hablando del siguiente. Epoch ayuda a recuperar distancia.
También resulta útil para entender que el progreso no ocurre de forma uniforme. Un modelo puede mejorar enormemente en razonamiento matemático y apenas avanzar en otra habilidad. Otro puede ampliar contexto, reducir precio o responder más rápido sin que eso signifique un salto equivalente en capacidad.
Si Artificial Analysis ayuda a elegir, Epoch ayuda a comprender. Y no siempre necesitamos lo mismo.
Vellum: comparar sin convertir la decisión en una tesis doctoral
Vellum (https://www.vellum.ai/llm-leaderboard) ocupa un lugar más práctico. Su leaderboard permite comparar modelos utilizando variables fáciles de trasladar al trabajo diario: precio, velocidad, latencia, contexto disponible y rendimiento en diferentes pruebas.
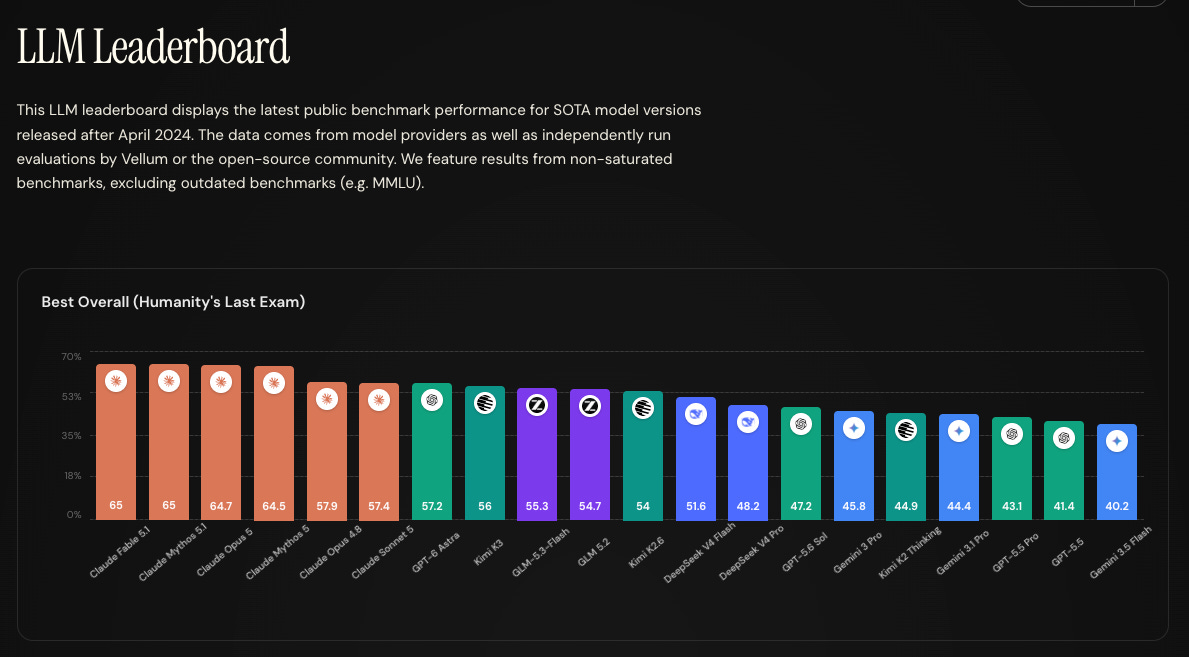
Es útil cuando ya hemos reducido la elección a dos o tres candidatos y queremos tomar una decisión sin pasar una tarde entera estudiando metodologías. ¿Cuál cuesta menos? ¿Cuál responde más rápido? ¿Qué ventana de contexto ofrece? ¿Cómo se comporta en determinados benchmarks?
La gran ventaja de Vellum es que recuerda algo que a veces olvidamos: no siempre necesitamos la IA más poderosa disponible. Necesitamos una que haga bien nuestro trabajo, dentro del presupuesto y sin obligarnos a esperar demasiado.
La obsesión por utilizar siempre el modelo más avanzado puede ser tan absurda como comprar la herramienta más cara de una ferretería sin saber qué tornillo queremos apretar.
El ranking perfecto no existe
Después de visitar estas seis webs, la situación parece más complicada que al principio, pero en realidad ocurre lo contrario. Lo que desaparece es la falsa simplicidad.
Artificial Analysis permite cruzar capacidad, precio y velocidad. Arena introduce la preferencia humana sin la influencia inicial de la marca. OpenRouter muestra qué modelos están siendo utilizados de verdad dentro de un gran ecosistema de desarrolladores. LiveBench intenta mantener útiles las pruebas evitando que el examen envejezca demasiado. Epoch permite observar el progreso con perspectiva histórica. Vellum simplifica la comparación cuando llega el momento de tomar una decisión práctica.
Ninguna ofrece la verdad completa porque ninguna está mirando exactamente lo mismo. Ese es el punto.
La infografía de Visual Capitalist con la que empezábamos sigue siendo útil. Nos dice algo importante: qué herramientas concentran atención y tráfico. El error sería pedirle que respondiera a una pregunta para la que nunca fue diseñada.
Mejor, sí. Pero ¿para qué?
Durante algún tiempo tuvo sentido preguntar cuál era la mejor inteligencia artificial. Había pocos modelos, las diferencias eran grandes y la respuesta podía resumirse con relativa facilidad. Esa etapa empieza a desaparecer.
Los modelos se multiplican, se especializan, bajan de precio y cambian demasiado rápido como para mantener un campeón estable. El que utilizamos para investigar puede no ser el mismo que elegimos para programar. El más potente puede no compensarnos si necesitamos procesar grandes volúmenes. Y el modelo que encabeza un benchmark puede no ser el que preferimos cuando trabajamos con él durante una hora.
Por eso la habilidad importante ya no consiste en memorizar quién ocupa hoy el primer puesto. Consiste en saber qué queremos hacer, qué variable importa en ese trabajo y dónde mirar para comprobarla.
Estas seis webs no deciden por nosotros. Hacen algo más útil: nos obligan a formular mejor la pregunta.
La próxima vez que alguien diga que una IA es “la mejor”, quizá no haga falta discutir.
Basta con preguntar:
¿La mejor para qué?
📬 Y si esta newsletter te ayuda a trabajar mejor, compártela. Cada semana seleccionamos solo herramientas que merecen tu tiempo.
Nos leemos pronto.